Alibaba ปล่อย harness ที่ทำให้ Qwen 3.7-Plus ทำงานยาวได้ดีกว่า Claude Opus 4.7 — เคล็ดลับคือเอา 'สถานะงาน' ออกจากบริบทการรัน แล้วตั้ง auditor อีกตัวมาตรวจของจริงก่อนเชื่อ
คำถามที่นักพัฒนา agent ถามกันมาทั้งปีคือ “ถ้าอยากให้ agent ทำงานยาว ๆ ได้ดีขึ้น ควรรอโมเดลใหม่ หรือควรแก้ harness?” วันที่ 3 สิงหาคม ทีม DreamX ของ Alibaba Group ตอบคำถามนี้ด้วยตัวเลขในเปเปอร์ LongHorizon-Harness (arXiv:2608.01964, 29 หน้า) และปล่อยโค้ดออกมาเป็น MIT บน GitHub (AMAP-ML/LongHorizon-Harness) เมื่อเช้าวันนี้ — repo เพิ่งสร้างวันที่ 4 ส.ค. และมี 110 ดาวแล้วในไม่กี่ชั่วโมง
คำตอบของเขาชัดมาก: ด้วยโมเดลตัวเดิมและ backend ตัวเดิม harness ที่ออกแบบดี ๆ ดัน Qwen 3.7-Plus บน WeaveBench จาก 51.8% ขึ้นไปเป็น 80.7% — เกือบสองเท่าของผลดีที่สุดที่เคยรายงานอย่างเป็นทางการบน benchmark นี้ ซึ่งคือ 41.2% ของ Claude Opus 4.7 ที่รันบน Claude Code เปล่า ๆ
ปัญหาที่แท้จริงไม่ใช่ “คิดไม่เก่ง” แต่คือ “จำสถานะไม่ได้”
เปเปอร์ระบุอาการล้มเหลวสามอย่างของ agent งานยาว: error สะสมจนหลุดเป้า (goal drift), context rot เมื่อประวัติยาวขึ้นจนหาข้อมูลสำคัญไม่เจอ และ task-state loss — agent ไม่รู้แล้วว่าอะไรทำไปแล้ว อะไรยังค้าง อะไรที่ค้นเจอมาจากสภาพแวดล้อม
รากของปัญหาตามที่ทีมวิเคราะห์คือ harness ปัจจุบัน (Claude Code, Codex CLI, OpenClaw) มีข้อจำกัดเชิงโครงสร้างสองข้อ: หนึ่ง — การรันงานกับการเก็บสถานะงานใช้ context ก้อนเดียวกัน ประวัติการรันที่โตขึ้นเรื่อย ๆ จึงกลบสถานะงานไปเอง; สอง — การรันงานกับการตัดสินว่าเสร็จหรือยังเป็นคนเดียวกัน agent ทำงานเองแล้วก็ตัดสินเองว่าเสร็จ ถ้าตัดสินผิด ความผิดนั้นจะถูกบันทึกเป็นสถานะและกลายเป็นข้อสมมติของทุกก้าวถัดไป
เคสตัวอย่างในเปเปอร์เห็นภาพชัด: baseline ที่ใช้ Claude Code เปิด dialog “Decode As” ของ Wireshark แล้วกดปุ่ม OK ไม่ติด — แล้วก็กดซ้ำอยู่อย่างนั้น เกิน 400 steps จนหมด budget เพราะความล้มเหลวไม่เคยถูกยกออกมาเป็น state object ข้างนอก มันจึงติดอยู่ใน context การรันและกลายเป็นการคลิกซ้ำไปเรื่อย ๆ
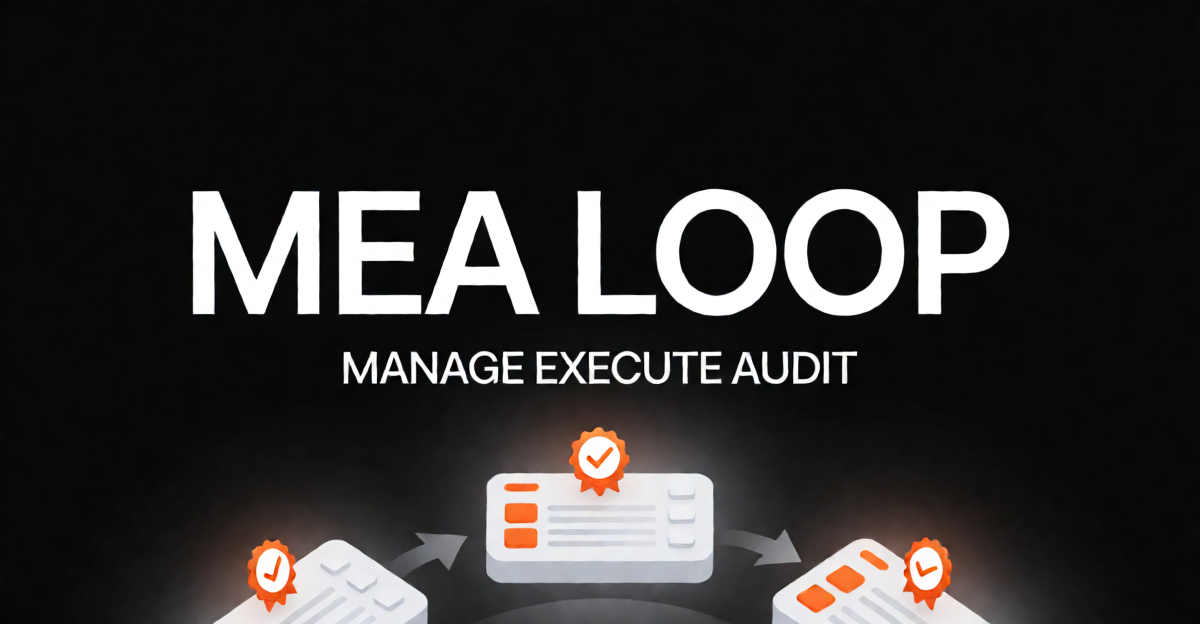
MEA loop: manager ห้ามแตะ environment, auditor ห้ามแก้อะไร
LongHorizon-Harness เปลี่ยนการรันงานยาวจาก session เดียวที่โตไปเรื่อย ๆ เป็นลูป Manage-Execute-Audit ที่แต่ละรอบถูกตรวจแยกอิสระ
- Manager ถือ task state ถาวร (requirement / artifact / fact แต่ละอันติดสถานะ completed, pending, blocked หรือ untrusted) และเลือกงานย่อยถัดไป จุดสำคัญคือ manager ไม่มีทางเข้าถึง environment เลย — เปิดไฟล์ไม่ได้ รันคำสั่งไม่ได้ ดูหน้าจอไม่ได้ ตัดสินใจจาก state กับหลักฐานที่ auditor บันทึกไว้เท่านั้น มันส่งกลับได้ 4 คำสั่ง:
execute,done,blocked,ask - Executor เป็นตัวเดียวที่ได้รับอนุญาตให้แก้ environment รับ “สัญญางานย่อย” (เป้าหมาย เกณฑ์รับงาน ขอบเขต หลักฐานที่เกี่ยวข้อง) แล้วรันใน context ใหม่หมดทุกรอบ พอจบรอบ trajectory ดิบกับ reasoning ภายในถูกทิ้ง เหลือส่งต่อแค่รายงานผล
- Auditor เป็น read-only ล้วน เข้าไปส่องสภาพแวดล้อมจริงว่าอะไรเปลี่ยนไปบ้าง เสร็จจริงไหม อะไรยังไม่ครบ — คำบอกของ executor ไม่ทำให้ state เปลี่ยนโดยตรง record จะถูกมาร์คว่า completed ก็ต่อเมื่อมีหลักฐานจาก audit รองรับ
มี AgentAdapter บาง ๆ คั่นไว้ ทำให้สลับ backend ได้โดยไม่ต้องแก้ agent loop เดิมของแต่ละระบบ — รองรับ Claude Code, Codex CLI, OpenClaw และ Hermes Agent และสลับโมเดลได้ระหว่าง Claude Opus, GPT, Qwen ตรงนี้แหละที่ทำให้มันเป็นของที่เอาไปใช้จริงได้ ไม่ใช่แค่ระบบวิจัยปิด
ตัวเลข: harness ยกพื้นความล้มเหลว ไม่ใช่ยกเพดานความสามารถ
ผลบน benchmark ทั้งสาม (โมเดลและโปรโตคอลเทียบเท่ากันหมด):
| Benchmark | baseline | LongHorizon-Harness |
|---|---|---|
| WeaveBench (Qwen 3.7-Plus + Claude Code) | 51.8% | 80.7% |
| Terminal-Bench 2.1 (Qwen 3.7-Plus) | 69.7% | 77.2% |
| OSWorld 2.0 เต็มชุด, binary completion (Qwen 3.7-Plus) | 2.8% | 8.3% |
| OSWorld 2.0 เต็มชุด, partial score | 21.5% | 35.2% |
| OSWorld 2.0 ชุดย่อย 34 งาน (Claude Opus 4.7) | 20.6% | 35.3% |
(ตัวเลขชุดย่อย OSWorld ในตาราง 3 คือ 20.6% → 35.3% ส่วนบทคัดย่อเขียนไว้ 20.0% → 34.3% — ต่างกันเล็กน้อยใน v1)
แต่ตัวเลขที่น่าสนใจที่สุดอยู่ในชุดย่อย WeaveBench Games 17 งาน ที่เทียบสองโมเดลบน harness เดียวกัน: Opus 4.7 ขึ้นจาก 0.680 เป็น 0.809 ส่วน Qwen 3.7-Plus ขึ้นจาก 0.524 เป็น 0.733 — นั่นแปลว่า Qwen ที่ใส่ harness นี้ ทำคะแนนสูงกว่า Opus 4.7 ที่รันบน Claude Code เปล่า (0.680) และงาน 6 ชิ้นที่ Qwen baseline ได้คะแนน ≤ 0.04 (คือพังยับ) ฟื้นขึ้นมาอยู่ที่ 0.30–0.92 ทั้งหมด
ทีมสรุปประเด็นนี้ตรง ๆ ว่า harness “ยกพื้นความล้มเหลว” (raises the failure floor) มากกว่าจะเพิ่มความสามารถใหม่ — และเขียนไว้ชัดว่าการตรวจสอบอิสระ “ตรวจเจอผลลัพธ์ที่ผิดและเริ่มกู้คืนได้ แต่มันให้ความสามารถที่โมเดลไม่มีอยู่แล้วไม่ได้” งานที่คอขวดอยู่ที่การแก้โจทย์ในแต่ละก้าว (เช่น ออกแบบอัลกอริทึม) จะไม่ได้อะไรจาก harness นี้เท่าไร
ค่าใช้จ่ายไม่ได้แพงขึ้นเสมอไป และ manager แทบไม่กิน token
ส่วนที่ผมคิดว่านักพัฒนาควรอ่านที่สุดคือการแยก token ตามบทบาท: manager กิน token แค่ 2.8% / 2.0% / 8.1% ของทั้งหมดบน WeaveBench, OSWorld 2.0 และ Terminal-Bench 2.1 ตามลำดับ — แปลว่าการเก็บ task state แบบชัดเจนแทบไม่มีต้นทุน ส่วน auditor กิน 19.4% / 24.8% / 38.1% คือการตรวจสอบอิสระต่างหากที่เป็นต้นทุนจริงของแนวคิดนี้
และต้นทุนรวมไม่ได้เป็นตัวคูณตายตัว: เทียบกับ baseline แล้วมันใช้ token 2.3 เท่า บน WeaveBench, 3.6 เท่า (output token) บน OSWorld 2.0 แต่ น้อยลง 24% บน Terminal-Bench 2.1 ทั้งที่คะแนนสูงกว่า
ที่พลิกความคาดหมายกว่านั้นคือบนชุด WeaveBench Games: Qwen ใช้ token เพิ่มจาก 10.7M เป็น 34.3M ต่องาน แต่ Opus ใช้ลดลงจาก 16.5M เหลือ 11.1M ทีมอธิบายว่าโมเดลที่แข็งแรงกว่าปิดสัญญางานย่อยได้ในรอบ audit–replan ที่น้อยกว่า ขณะที่โมเดลอ่อนกว่าต้องเผาการรันซ้ำและการกู้คืน — พูดง่าย ๆ คือยิ่งโมเดลเก่ง harness นี้ยิ่งถูกลง ไม่ใช่แพงขึ้น
มุมมอง AI Curator
เปเปอร์นี้พูดสิ่งที่หลายทีมในไทยน่าจะอยากได้ยิน: ถ้าคุณจ่ายค่า API โมเดล frontier ไม่ไหว ทางออกอาจไม่ใช่รอราคาลด แต่คือลงทุนกับ harness ตัวเลข 0.733 ของ Qwen ที่ชนะ 0.680 ของ Opus 4.7 บน harness เปล่า เป็นหลักฐานเชิงประจักษ์ชิ้นแรก ๆ ที่วัดได้ว่า “ความสามารถของ agent เป็นคุณสมบัติของทั้งระบบ model+harness” ไม่ใช่ของโมเดลอย่างเดียว สำหรับสตาร์ตอัพหรือทีมองค์กรที่ต้องรัน agent บนโมเดลราคาถูกกว่าเพราะ budget หรือเพราะข้อกำหนด data residency นี่คือทางที่ทำได้จริงและโค้ดก็เปิดแล้ว
แต่ต้องอ่านตัวเลขให้ตรง สองอย่าง หนึ่ง — OSWorld 2.0 เต็มชุดขึ้นจาก 2.8% เป็น 8.3% ฟังดูเป็น 3 เท่า แต่ค่าสัมบูรณ์ยังคือ “ทำงาน desktop จบได้ 8 จาก 100 งาน” งาน computer-use ยังไม่ใกล้พร้อมใช้จริง สอง — คำเตือนของทีมเองที่ว่า auditor ให้ความสามารถที่โมเดลไม่มีไม่ได้ แปลว่าถ้าคุณเอา harness นี้ไปครอบโมเดลเล็ก ๆ ที่แก้โจทย์ในแต่ละก้าวไม่ได้อยู่แล้ว มันก็แค่จะล้มเหลวอย่างเป็นระเบียบและแพงขึ้น
สิ่งที่ผมคิดว่านำไปใช้ได้ทันทีโดยไม่ต้องติดตั้งอะไรเลยคือหลักการเดียว: อย่าให้ agent ตัวที่ทำงาน เป็นตัวตัดสินเองว่างานเสร็จ จะทำเป็น subagent, ทำเป็น script ตรวจ, หรือทำเป็น test ที่รันจริงก็ได้ — แต่ให้หลักฐานจากสภาพแวดล้อมเป็นตัวเปลี่ยนสถานะ ไม่ใช่คำประกาศของโมเดล ที่น่าสังเกตคือหลักการนี้ตรงกับ พิมพ์เขียว agent ที่ต้องขออนุญาตก่อนลงมือของ Microsoft ที่เราเขียนไปเมื่อเช้า ซึ่งแยก tool อ่านออกจาก tool เขียนด้วยเหตุผลคนละอย่างแต่ได้โครงสร้างคล้ายกัน — สองทีมที่ไม่เกี่ยวกันเลยกำลังขุดเจอรูปทรงเดียวกันในสัปดาห์เดียวกัน
แหล่งข่าว
อ่านเพิ่มในหมวด เครื่องมือนักพัฒนา

Betelgeuse รัน Qwen3.8 Flash Next ขนาด 68GB บน RTX 3060 กับแรม 16GB ส่วน Basalt วัดให้เห็นว่าเอนจินที่เร่งด้วยแฟล็กลัดทำให้โมเดลลืมของ
Betelgeuse ฟอร์ก llama.cpp ที่เปิดเมื่อ 31 ต.ค. ดึง expert จาก NVMe เข้า VRAM ตามต้องการ อ้าง 22 tok/s แบบไม่ทิ้ง expert แต่ README เตือนเองว่ายังทดลองและตัวเลขมาจากคนละรอบ วันเดียวกันผู้พัฒนา Basalt เผยผลวัดว่าแฟล็กเร่งความเร็วทำคุณภาพ Q8 ตกไปใกล้ Q2

กฎห้ามโคลนเกมของ Claude Code เริ่มกระทบงานจริง บริษัทรับทำเกมกระดานร้องงานลูกค้าหยุด แต่รายงานหลายชิ้นปนกับตัวกรองไซเบอร์คนละเรื่อง
ต่อจากที่เราพบกฎนี้ในไบนารี Claude Code ผู้ใช้เริ่มรายงานว่างานเชิงพาณิชย์ถูกปฏิเสธ และ Tom's Hardware กับ Mashable หยิบไปรายงาน แต่เมื่อไล่ issue ที่อ้างถึง พบว่าหลายรายการเกิดก่อนกฎจะมา จึงน่าจะเป็นตัวกรองด้านไซเบอร์ ส่วน Anthropic ยังไม่ชี้แจง

Claude Code ส่ง transcript ของ background agent ให้โมเดลทุก ~30 วินาทีเพื่อเขียนสถานะ 3–5 คำ ผู้วัดรายงานกินราว 16% และยังปิดแบบทางการไม่ได้
รายงานอิสระพบว่าฟีเจอร์ agent_summary ของ Claude Code ส่ง transcript เต็มของ background agent ไปถามสถานะทุก ~30 วินาที คิดเป็น 16.4% ของค่าใช้จ่ายในระบบของผู้วัด Issue เปิดมาตั้งแต่ ส.ค. ยังไม่มีสวิตช์ปิดที่รองรับ เราตรวจพบโค้ดนี้ใน 2.1.314 และพบกฎใหม่เรื่องเกมที่ไม่อยู่ใน changelog